[사회조사분석사 2급 필기] 13년 1회차 기출문제 정답·해설 페이지
- A. 정장과 캐주얼 의상을 파는 상점들은 경쟁이 치열합니까?
- B. 무상 의료제도를 시행한다면, 그 비용은 시민들이 추가적으로 부담하여야 한다고 생각하십니까, 아니면 다른 분야의 예산을 줄여 충당해야 한다고 생각하십니까?
- C. 귀하는 작년 여름에 해운대 해수욕장에 가 보신 적이 있으십니까?
- D. 귀하는 귀하의 직장에서 받는 임금수준에 대하여 만족하십니까?
- 정장과 캐주얼 의상 상점의 경쟁을 묻는 질문은 서로 다른 두 업종을 한꺼번에 묻는 이중질문이어서, 한쪽만 치열한 경우 응답할 수 없다.
- 무상 의료제도의 비용 부담을 묻는 질문은 제도 시행을 전제로 깔고 두 가지 대안 중 하나를 고르도록 강요하는 형태여서, 제도 자체에 반대하거나 제3의 대안을 가진 응답자를 배제한다.
- A. 대단위 모집단의 태도와 성향을 측정할 때, 적합한 방법이다.
- B. 개인, 집단, 사회적 가공물(social artifacts)등을 분석단위로 사용한다.
- C. 표본의 소재(location)에 관한 정보가 부족할 때 눈덩이 표집으로 할 수 있다.
- D. 현상의 기술(description)을 목적으로 사용할 수 있다.
- A. 융통성이 있다.
- B. 면접결과의 신뢰도가 높다.
- C. 면접결과자료의 수량화 및 통계처리가 용이 하다.
- D. 표준화면접에서 필요한 변수를 찾아내는데 유용한 자료를 제공한다.
- 면접결과의 신뢰도가 높은 것은 표준화 면접의 장점이다 — 모든 응답자에게 동일한 질문을 동일한 순서로 하기 때문에 면접자에 따른 편차가 작다.
- 자료의 수량화와 통계처리가 용이한 것도 표준화 면접 쪽이다. 비표준화 면접은 응답 형식이 제각각이어서 비교와 계량화가 어렵다.
- 특수한 것보다 일반적인 것을 먼저 묻고 특수한 것을 나중에 배열한다.
- 사생활이나 민감한 내용은 응답자가 조사에 어느 정도 익숙해진 뒤인 나중에 묻는다.
- 비슷한 형태의 질문을 계속 배열하면 응답자에게 정형화된 반응(response set)이 생겨 응답의 정확성이 떨어지므로 피해야 한다.
- A. 조사 설계
- C. 연구주제의 선정
- E. 자료 분석 및 해석
- B. 자료수집
- D. 연구보고서 작성
- F. 가설의 구성 및 조작화
- 시간 경과에 따른 대상자의 자연스러운 신체적·심리적 변화를 뜻하는 성숙효과는 범죄율이라는 집단 지표의 급등락을 설명하지 못한다.
- 사전검사 경험이 사후검사 점수에 영향을 주는 검사효과나, 측정도구·측정자가 바뀌어 생기는 도구효과는 이 사례에 검사 실시나 도구 변경이 없어 해당하지 않는다.
- 자연스러운 상태에서 현상을 파악할 수 있기 때문에 미묘한 어감차이, 시간상의 변화 등 심층의 차원을 이해할 수 있다.
- 때때로 객관적인 판단을 그르칠 수 있으며, 대규모 모집단에 대한 기술이 어렵다.
- 의사실험은 무작위 배정 없이 처치효과를 보는 설계로, 자연스러운 상태의 심층 이해와는 목적이 다르다.
- 내용분석은 이미 만들어진 기록물을 대상으로 하므로 현장의 어감이나 상호작용을 직접 관찰하지 않는다.
- 우편조사는 표준화된 설문지로 대규모 모집단을 기술하기에 오히려 유리한 방법이어서 제시된 단점과 정반대다.
- 매칭은 외생변수의 값이 비슷한 대상끼리 짝지어 집단에 배치하는 방법으로, 순서효과를 다루는 장치가 아니다.
- 제거는 문제되는 외생변수를 아예 실험에서 배제하는 방법이고, 무작위화는 대상을 무작위로 배정해 외생변수를 확률적으로 균등화하는 방법이어서 동일 집단에 순서를 바꿔 두 번 처치하는 이 사례와 다르다.
- 사회의 양극화나 경제성장과 사회혼란의 관계를 서술한 문장은 변수 간 관계가 모호하거나 조작화가 어렵다.
- '~해야 한다'는 식의 규범적·당위적 진술은 사실 여부를 검증할 수 있는 가설이 아니라 가치판단이다.
- 표본이 작고 맥락 의존적이어서 일반화 가능성은 양적연구보다 낮다.
- 가설을 미리 세우고 검증하는 연역적 방법이 아니라 귀납적 방법을 주로 사용한다.
- 변수 간 관계 검증이나 이론 검증에 유용한 쪽은 양적연구이다.
- A. 4개의 집단으로 구성한다.
- B. 사후측정만 하는 집단은 2개이다.
- C. 검사와 개입의 상호작용효과를 도출할 수 있다.
- D. 통제집단 사전사후검사설계와 비동일 비교집단 설계를 합한 형태이다.
- 조작적 정의는 연구자마다 동일할 필요가 없으며 연구목적에 맞게 다르게 규정될 수 있다.
- 이론적·추상적 정의는 조작적 정의가 아니라 개념적 정의에 해당한다.
- 정의가 구체적일수록 측정 절차가 명확해져 후속 연구에서의 재현이 오히려 쉬워진다.
- A. 표본추출
- B. 표본틀의 결정
- C. 표본추출방법의 결정
- D. 표본의 크기결정
- E. 모집단의 확정
- 각각의 문항은 측정하고자 하는 개념의 속성에 대해 동일한 기여를 한다.
- 내적 일관성 검증을 통해 신뢰도가 낮은 항목은 삭제할 필요가 있다.
- 각 문항별 응답점수의 총합이 측정하고자 하는 개념을 대표한다는 가정에 근거한다.
- 거트만 척도는 문항이 강도 순으로 누적되어 재생계수로 평가하므로 문항별 기여가 동일하지 않다.
- 서스톤 척도는 평가자단이 문항마다 서로 다른 척도값(가중치)을 미리 부여한다.
- 의미분화 척도는 대칭 형용사 쌍 사이의 연속선 위에 응답하게 하는 방식이다.
- 단순무작위추출은 모든 요소를 매번 독립적으로 무작위 추출하므로 고정된 간격을 쓰지 않는다.
- 층화추출은 모집단을 동질적인 층으로 나눈 뒤 층별로 뽑는데, 여기에는 층 구분 자체가 없다.
- 집락추출은 집락 단위를 뽑아 그 안을 조사하는 방식인데 여기서는 개인 단위로 추출했다.
- 서스톤척도는 평가자단이 문항마다 척도값을 부여해 등간성을 확보하는 방식이다.
- 거트만척도는 강도가 누적되도록 배열된 문항을 쓴다.
- 리커트척도는 '매우 그렇다~전혀 아니다' 식으로 동의 정도를 묻고 총점을 낸다.
- 총화평정 척도와 리커트 척도는 사실상 같은 계열로, 여러 문항의 응답점수를 합산한 총점으로 개념을 재기 때문에 단계별 수용 수준을 하나 고르게 하는 이 형식과 다르다.
- 서스톤척도는 평가자단이 문항에 척도값을 미리 부여해 등간성을 만든 뒤 응답자가 동의하는 문항을 고르게 하는 방식이다.
- 내용타당도는 측정도구가 측정하려는 내용 영역을 대표하는지를 전문가 판단으로 보는 것이라 사후 성과와는 무관하다.
- 수렴타당도는 같은 개념을 재는 다른 측정치와 높은 상관을 보이는지, 판별타당도는 다른 개념의 측정치와 낮은 상관을 보이는지를 따지는 구성타당도의 하위 개념이다.
- A. 학업부진은 독립변수이고 비행은 종속변수이다.
- B. 비행친구와의 사귐은 매개변수이다.
- C. 선생님의 관심은 조절변수이다.
- D. 어릴적 가정환경은 외생변수이다.
- A. 응답자들을 순서대로 구분할 수 있다.
- B. 절대 영점(absolute zero score)을 지니고 있다.
- C. 어떤 응급자의 특성이 다른 응답자의 특성보다 몇 배가 높은지 알 수 있다.
- 절대 영점(absolute zero score)은 무게·소득처럼 '없음'이 0으로 정의되는 비율척도의 성질이다.
- 어떤 응답자의 특성이 다른 응답자보다 몇 배 높은지 말할 수 있으려면 절대 영점이 있어야 하므로 이 역시 비율척도의 성질이다.
- A. 쌍대비교법(paired comparison)
- B. 순위법(rank-order)
- C. 고정총합법(constant sum)
- D. 연속평정법(continuous rating)
- E. 항목평정법(itemized rating)
- 봉우리의 가로 위치가 곧 최빈값이므로 A의 최빈값이 B보다 왼쪽, 즉 더 작다.
- A는 퍼짐의 폭이 넓고 B는 좁으므로 A의 분산이 더 크다.
- A처럼 오른쪽 꼬리가 길게 늘어진 분포는 양(+)의 왜도를 갖는다.
- 독립변수와 종속변수의 함수관계를 통계적으로 규명한다는 설명은 회귀분석의 정의로 옳다.
- 종속변수에 영향을 미치는 주요 독립변수를 파악할 수 있다는 설명도 회귀분석의 활용 목적으로 옳다.
- 단순선형회귀모형의 오차항이 이고 서로 독립이라는 가정도 표준 가정으로 옳다.
- 분산이 편차제곱의 평균이라는 정의는 옳다.
- 자료가 평균에 밀집할수록 분산이 작아진다는 설명도 옳다.
- 모든 자료값이 동일하면 편차가 전부 0이 되어 분산도 0이 된다는 설명 역시 옳다.
- 표본평균끼리 로 놓은 것은 자료에서 계산된 통계량 사이의 등식이어서 모수에 대한 가설이 될 수 없다.
- "적어도 하나는 0이 아니다"는 대립가설의 서술이고, 오차항과 처리효과의 독립성은 모형의 가정이지 분산분석표로 검정하는 대상이 아니다.
- 표본으로 확실히 입증하고자 하는 가설은 귀무가설이 아니라 대립가설(연구가설)이다.
- 유의수준은 제2종 오류가 아니라 제1종 오류를 범할 확률의 최대 허용한계이다.
- 대립가설을 채택하게 하는 검정통계량의 영역은 채택역이 아니라 기각역이라 부른다.
- 은 이산형에서 을 그대로 쓴 식이다.
- 은 같은 식의 연속형 표현이다.
- 은 분산의 정의식이며 전개하면 이 된다.
- 단순회귀모형에서 결정계수가 상관계수의 제곱과 같다는 설명은 옳다.
- 독립변수의 수가 늘어날수록 결정계수가 커지는 경향이 있다는 설명도 옳다.
- 결정계수의 값이 0에서 1 사이라는 설명도 옳다.
질문지 문항 작성 원칙에 부합하는 질문을 모두 짝지은 것은?
A, B
B, C
C, D
A, D
해운대 해수욕장 방문 경험을 묻는 질문과 임금수준 만족도를 묻는 질문이 한 문항에 하나의 쟁점만 담은 올바른 문항이다.
질문지 작성의 기본은 이중질문(double-barreled question) 금지와 단일 쟁점·명확한 응답 대상이다. 방문 경험 문항은 시점(작년 여름)과 장소(해운대 해수욕장)가 특정되어 있고, 임금수준 문항도 만족 여부라는 단일 차원만 묻는다.
오류나 개정된 내용이 보이면 알려주세요
연역법과 귀납법에 관한 설명으로 옳은 것은?
연역법은 선(先)조사 후(後)이론의 방법을 택한다.
연역법과 귀납법은 상호보완적으로 사용할 수 없다.
연역법과 귀납법의 선택은 조사의 용이성에 달려 있다.
기존 이론의 확인을 위해서는 연역법을 주로 사용한다.
기존 이론을 확인하기 위해서는 연역법을 주로 사용한다.
연역법은 이론에서 출발해 가설을 도출하고 이를 관찰·경험으로 검증하는 절차이므로 선(先)이론 후(後)조사의 방법이며, 귀납법은 관찰된 사실로부터 이론을 이끌어내는 선조사 후이론의 방법이다.
두 방법은 조사의 용이성이 아니라 연구목적에 따라 선택되며, 실제 연구에서는 상호보완적으로 함께 사용되는 경우가 많다.
오류나 개정된 내용이 보이면 알려주세요
설문 조사에 관한 옳은 설명을 모두 짝지은 것은?
A, B
B, C
A, C, D
A, B, C, D
제시된 네 설명이 모두 옳다.
설문조사는 표본을 통해 모집단의 특성을 추정하는 방법이므로 대단위 모집단의 태도·성향 측정에 특히 적합하고, 분석단위도 개인에 국한되지 않아 집단이나 사회적 가공물까지 대상으로 삼을 수 있다.
또한 표본의 소재를 알기 어려운 희귀·은폐 집단에서는 응답자가 다음 응답자를 소개하는 눈덩이 표집을 활용할 수 있고, 설문조사의 목적은 인과관계 설명뿐 아니라 현상의 기술(description)과 탐색까지 포괄한다.
오류나 개정된 내용이 보이면 알려주세요
비표준화(비구조화) 면접의 장점을 모두 짝지은 것은?
A, B
B, C
C, D
A, D
비표준화 면접의 장점은 융통성과, 표준화면접에 쓸 변수를 발굴하는 데 유용한 자료를 준다는 점이다.
비표준화 면접은 질문의 내용·순서·표현을 상황에 맞춰 바꿀 수 있어 응답자의 맥락에 따라 깊이 파고들 수 있고, 이렇게 얻은 풍부한 자료는 뒤이어 구조화된 설문이나 표준화면접을 설계할 때 측정할 변수와 문항을 도출하는 예비조사 역할을 한다.
오류나 개정된 내용이 보이면 알려주세요
종단연구와 비교한 횡단연구의 장점과 가장 거리가 먼 것은?
일반적으로 비용이 적게 든다.
엄밀한 인과관계의 검증에 유리하다.
검사효과로 인해 왜곡될 가능성이 낮다.
조사대상자에 대한 사생활침해의 우려가 낮다.
횡단연구는 한 시점에서 조사가 이루어지므로 엄밀한 인과관계 검증에는 오히려 불리하다.
인과관계를 엄밀히 검증하려면 시간적 선후관계를 확인할 수 있어야 하는데, 이는 동일 대상을 여러 시점에서 반복 조사하는 종단연구의 장점에 해당한다.
횡단연구는 한 번의 조사로 끝나므로 상대적으로 비용이 적게 들고, 반복측정에 따른 검사효과나 사생활 침해 우려도 낮다.
오류나 개정된 내용이 보이면 알려주세요
질문문항의 배열에 관한 설명으로 옳은 것은?
특수한 것을 먼저 묻고 일반적인 것은 나중에 질문한다.
개인의 사생활에 대한 것이나 민감한 내용은 먼저 묻는다.
시작하는 질문은 흥미를 유발하는 것으로 쉽게 응답할 수 있는 것으로 한다.
비슷한 형태로 질문을 계속하여 응답에 정형이 생기게 한다.
설문 문항은 흥미를 유발하고 답하기 쉬운 질문으로 시작하는 것이 바람직하다.
오류나 개정된 내용이 보이면 알려주세요
과학적 조사방법의 일반적인 과정을 바르게 나열 한 것은?
A → B → C → E → F → D
A → E → C → B → F → D
C → F → A → B → E → D
C → A → F → B → E → D
과학적 조사는 연구주제의 선정 → 가설의 구성 및 조작화 → 조사 설계 → 자료수집 → 자료 분석 및 해석 → 연구보고서 작성 순으로 진행된다.
먼저 무엇을 연구할지 주제를 정한 뒤에야 검증할 가설을 세우고 개념을 측정 가능한 형태로 조작적으로 정의할 수 있다. 가설이 확정되어야 표본·측정도구·조사방법을 정하는 조사 설계가 가능하므로, 설계가 주제 선정보다 앞서는 배열은 성립하지 않는다.
설계에 따라 실제로 자료를 모으고, 모은 자료를 통계적으로 분석·해석해 가설의 채택 여부를 판단한 다음, 마지막으로 그 결과를 보고서로 작성해 마무리한다.
오류나 개정된 내용이 보이면 알려주세요
다음 중 면접원의 자율성이 가장 적은 면접 유형은?
초점집단면접
심층면접
구조화면접
임상면접
면접원의 자율성이 가장 적은 유형은 구조화면접이다.
구조화면접은 질문의 내용과 순서, 표현이 표준화된 질문지에 따라 진행되므로 면접원이 임의로 질문을 바꾸거나 순서를 조정할 여지가 거의 없다.
반면 초점집단면접, 심층면접, 임상면접은 상황에 따라 질문을 유연하게 조정하는 비구조화·반구조화 방식으로 면접원의 자율성이 상대적으로 크다.
오류나 개정된 내용이 보이면 알려주세요
설문지 작성과정 중 사전검사(pre-test)를 실시하는 이유와 가장 거리가 먼 것은?
연구하려는 문제의 핵심적인 요소가 무엇인지 확인한다.
응답이 한쪽으로 치우치지 않는지 확인한다.
질문 순서가 바뀌었을 때, 응답에 실질적 변화가 일어나는지 확인한다.
무응답, 기타응답이 많이 발생하는 경우를 확인한다.
사전검사(pre-test)는 완성된 설문지를 실제 조사 전 소규모로 시행해보는 절차이므로, 연구문제의 핵심 요소를 확인하는 것은 그 목적이 아니다.
연구문제의 핵심 요소를 찾는 작업은 설문지 작성 이전 단계인 탐색적 조사나 예비조사의 목적에 해당한다.
사전검사는 완성된 문항을 대상으로 응답의 편중 여부, 질문 순서에 따른 응답 변화, 무응답·기타응답의 과다 발생 여부 등 문항 자체의 문제점을 점검하는 데 목적이 있다.
오류나 개정된 내용이 보이면 알려주세요
탐색적 조사(exploratory research)에 관한 설명으로 옳은 것은?
시간의 흐름에 따라 일반적인 대상 집단의 변화를 관찰하는 조사이다.
어떤 현상을 정확하게 기술하는 것을 주목적으로 하는 조사이다.
동일한 표본을 대상으로 일정한 시간간격을 두고 반복적으로 측정하는 조사이다.
연구문제의 발견, 변수의 규명, 가설의 도출을 위해서 실시하는 조사로서 예비적 조사로 실시한다.
탐색적 조사는 연구문제의 발견, 변수의 규명, 가설의 도출을 위한 예비적 조사이다.
본 조사에 앞서 문제를 명확히 하고 조사 방향을 설정하기 위해 실시하며, 문헌조사·전문가 의견조사·사례조사 등의 방법이 활용된다.
오류나 개정된 내용이 보이면 알려주세요
다음 사례에서 가장 문제될 수 있는 타당도 저해 요인은?2008년 경제위기로 인해 범죄율이 급격히 증가하였고, 이에 경찰은 2009년 순찰활동을 크게 강화하였다. 2010년 범죄율은 급속히 떨어졌고, 경찰은 순찰활동이 범죄율의 하락에 크게 영향을 미쳤다고 발표하였다.
성숙효과(maturation)
통계적 회귀(statistical regression)
검사효과(testing effect)
도구효과(instrumentation)
극단적으로 높아진 값이 시간이 지나면 저절로 평균 수준으로 되돌아가는 통계적 회귀가 가장 문제되는 요인이다.
사례에서 2008년 범죄율은 경제위기라는 일시적 충격으로 비정상적으로 높은 극단값이었다. 이런 극단값은 다음 시점에 별다른 처치가 없어도 평균 쪽으로 낮아지는 경향이 있으므로, 2010년의 하락분을 모두 순찰 강화의 효과로 돌리면 처치효과를 과대평가하게 된다.
오류나 개정된 내용이 보이면 알려주세요
다음 중 동일한 표본을 대상으로 동일한 내용의 설문을 일정한 시간 간격을 두고 계속해서 조사 하는 설계는?
요인설계
교차분석 설계
계속적 표본설계
패널 조사설계
동일한 표본을 대상으로 동일한 내용을 일정한 시간 간격을 두고 반복 조사하는 설계는 패널 조사설계이다.
패널조사는 같은 응답자 집단(패널)을 지속적으로 추적 조사하여 시간에 따른 변화를 파악하는 종단연구의 한 유형이다.
오류나 개정된 내용이 보이면 알려주세요
김치의 상품화로부터 연상될 수 있는 배추, 각종 양념, 숙성 정도, 가격 등과 같은 시험단어들에 대하여 응답자들이 연상해내는 단어들의 순서와 반응시간 등을 측정하여 조사에 활용되는 방법은?
설문지법
서베이법
투사법
면접법
제시된 내용은 단어 자극에 대한 연상 반응을 통해 심리를 간접적으로 파악하는 투사법에 해당한다.
투사법 중 단어연상법은 자극단어를 제시하고 응답자가 즉각적으로 떠올리는 단어와 그 순서, 반응시간을 측정하여 응답자의 잠재된 태도나 인식을 추론하는 기법이다.
오류나 개정된 내용이 보이면 알려주세요
면접 설문조사와 비교할 때 폐쇄형 설문조사의 장점으로 옳은 것은?
복잡한 쟁점을 다룰 때 효과적이다.
설문의 응답률이 높다.
개인의 민감한 문제를 다루는데 유리하다.
혼동을 일으키는 질문에 대한 추가설명이 가능하다.
폐쇄형 설문조사는 제시된 보기 중에서 골라 답하면 되고 익명성이 보장되므로 개인의 민감한 문제를 다루는 데 유리하다.
면접원과 얼굴을 마주하지 않고 응답할 수 있어 사회적으로 바람직한 방향으로 답을 꾸미려는 부담이 적고, 자신의 응답이 노출된다는 우려도 작기 때문이다.
반면 복잡한 쟁점을 깊이 있게 다루거나, 혼동을 일으키는 질문에 추가 설명을 해 주는 일, 그리고 높은 응답률을 확보하는 것은 조사원이 직접 접촉하는 면접조사가 더 유리한 부분이다.
오류나 개정된 내용이 보이면 알려주세요
다음의 특성을 가진 연구방법은?
참여관찰(participant observation)
의사실험(quasi-experiment)
내용분석(contents analysis)
우편조사(mail survey)
연구자가 현장에 들어가 구성원의 일상을 함께 겪으며 관찰하는 참여관찰의 특성이다.
참여관찰은 인위적 조작 없이 자연스러운 상태에서 자료를 얻으므로 말투의 미묘한 어감차이나 시간에 따른 변화 같은 심층적 차원을 포착할 수 있다. 반면 연구자가 대상에 깊이 개입하는 만큼 주관이 섞여 객관성이 흔들릴 수 있고, 소수 사례에 집중하기 때문에 대규모 모집단을 기술하기는 어렵다.
오류나 개정된 내용이 보이면 알려주세요
표본조사와 전수조사에 대한 설명으로 틀린 것은?
표본조사 과정에서 발생하는 비표본오류 때문에 표본조사는 전수조사보다 부정확하다.
전수조사는 표본조사보다 많은 비용과 시간이 필요로 한다.
표본조사는 현실적으로 전수조사가 필요 없거나 불가능할 때 이용한다.
모집단이 작은 경우 추정의 정도를 높이는데 전수조사가 훨씬 정밀하다.
표본조사가 비표본오류 때문에 전수조사보다 부정확하다는 설명은 틀렸다.
표본조사는 조사 규모가 작아 관리와 통제가 상대적으로 용이하므로 오히려 비표본오류를 줄이기 쉽고, 대규모로 이루어지는 전수조사는 관리 소홀 등으로 비표본오류가 더 커질 수 있다.
따라서 표본조사가 전수조사보다 반드시 부정확하다고 단정할 수 없으며, 나머지 설명들(전수조사의 높은 비용·시간, 표본조사의 필요성, 소규모 모집단에서 전수조사의 정밀성)은 타당하다.
오류나 개정된 내용이 보이면 알려주세요
이론에 관한 설명으로 틀린 것은?
이론은 수정되지 않는다.
사실을 논리적으로 설명한다.
개념 간의 관계를 보여준다.
일반화된 규칙성을 포함한다.
이론은 새로운 증거나 연구 결과에 의해 수정될 수 있다.
이론은 개념 간의 관계를 논리적으로 설명하고 일반화된 규칙성을 포함하지만, 고정불변의 것이 아니라 반증되거나 새로운 사실이 발견되면 수정·보완되는 잠정적 지식체계이다.
오류나 개정된 내용이 보이면 알려주세요
2000년부터 2012년까지 주요 일간신문에 나타난 기사를 분석하여, 대북정책 경향을 파악하는 연구를 하였다. 여기서 사용한 연구방법에 관한 설명으로 틀린 것은?
조사 반응성을 일으키지 않는다.
다양한 기록자료 유형을 분석대상으로 할 수있다.
연구에 오류가 있을 때 재시행이 용이하지 않다.
대상자에 대한 직접 조사가 어려울 때 사용한다.
신문기사를 분석하는 내용분석법은 기록물이 그대로 보존되므로 오류가 있을 때 재시행이 오히려 용이하다.
이미 발표된 기사라는 기록자료를 분석 대상으로 하므로 조사대상에게 직접 접촉하지 않아 조사 반응성이 발생하지 않으며, 다양한 유형의 기록자료를 분석할 수 있고 대상자에 대한 직접 조사가 어려운 경우에도 사용할 수 있다.
또한 원자료(기사)가 그대로 남아 있으므로 분석에 오류가 발견되면 같은 자료로 다시 분석하기가 용이하여, 재시행이 어렵다는 설명은 사실과 반대된다.
오류나 개정된 내용이 보이면 알려주세요
어떤 연구에서 “미국의 도시 중 동양인의 비율이 높은 도시가 동양인의 비율이 낮은 도시보다 정신질환 발병률이 높다.”는 결과를 얻었을 때, 이러 한 연구결과로부터 “백인 정신질환자보다 동양인 정 신질환자가 더 많다.”고 결론을 내리는 오류를 무엇이라고 하는가?
조건화 오류
생태학적 오류
개인주의적 오류
일반화 오류
집단 수준(도시)의 통계를 근거로 개인 수준(동양인 대 백인)의 결론을 내리는 오류를 생태학적 오류라고 한다.
동양인 비율이 높은 도시에서 정신질환 발병률이 높다는 집단 단위의 상관관계를, 개인 단위인 동양인 정신질환자 수가 백인보다 많다는 결론으로 곧바로 확대 해석하는 것은 분석단위를 혼동한 대표적인 생태학적 오류이다.
오류나 개정된 내용이 보이면 알려주세요
초점집단면접(focus group interview)에 관한 설명으로 틀린 것은?
자료의 통계적 분석이 어렵다.
높은 유연성과 타당도를 가진다.
개인면접보다 통제하기가 수월하다.
실제 상황에 대한 구체적인 정보를 얻을 수 있다.
초점집단면접은 여러 응답자가 동시에 참여해 상호작용하며 진행되므로 개인면접보다 통제하기가 오히려 어렵다.
여러 참여자의 발언과 상호작용을 동시에 다루어야 하므로 진행자의 통제력이 개인면접에 비해 떨어질 수 있다.
반면 실제 상황과 유사한 집단 역동 속에서 구체적인 정보를 얻을 수 있고 높은 유연성과 타당도를 가지는 대신, 응답이 정형화되어 있지 않아 통계적 분석은 어렵다.
오류나 개정된 내용이 보이면 알려주세요
과학적 방법의 특징에 관한 설명으로 틀린 것은?
간결성 : 최소한의 설명변수만을 사용하여 최대의 설명력을 얻는다.
인과성 : 모든 현상은 자연발생적인 것이어야 한다.
일반성 : 경험을 통해 얻은 구체적인 사실로 보편적인 원리를 추구한다.
경험적 검증가능성 : 이론은 현실세계에서 경험을 통해 검증이 될 수 있어야 한다.
과학적 방법의 인과성은 원인과 결과의 관계를 규명하는 것이지, 모든 현상이 자연발생적이어야 한다는 의미가 아니다.
간결성은 최소한의 설명변수로 최대의 설명력을 얻는 것, 일반성은 구체적 경험을 통해 보편적 원리를 추구하는 것, 경험적 검증가능성은 이론이 현실에서 검증될 수 있어야 한다는 것으로 모두 타당한 설명이다.
오류나 개정된 내용이 보이면 알려주세요
다음 설명은 외생변수를 통제하는 방법 중 무엇 에 해당하는가?하나의 실험집단에 2개 이상의 실험변수가 가해지는 경우 사용하는 방법이다. 예를 들면, 두 가지 광고 A와 B에 대한 사람들의 선호도를 알아보고자 할 때, 광고의 제시 순서가 그 광고에 대한 사람들의 선호도에 영향을 미칠 수 있다.
이때, 실험집단 참여자의 반에게는 광고를 A→B의 순으로 제시하고, 나머지 반에게는 B→A의 순으로 제시하여, 각 광고에 대한 그들의 선호도를 측정한다.
매칭(matching)
제거(elimination)
무작위화(randomization)
상쇄(counterbalancing)
제시 순서가 만드는 효과를 서로 상쇄시키기 위해 순서를 뒤바꿔 배정하는 상쇄(counterbalancing)에 해당한다.
하나의 실험집단에 두 개 이상의 실험변수를 차례로 가하면 제시 순서 자체가 외생변수가 된다. 참여자의 절반에게는 A→B, 나머지 절반에게는 B→A 순으로 제시하면 순서로 인한 효과가 두 방향에서 서로 맞상쇄되어 광고 자체의 선호도만 남는다.
오류나 개정된 내용이 보이면 알려주세요
관찰법(observation method)의 분류기준에 관한 설명으로 틀린 것은?
관찰이 일어나는 상황이 인공적인지 여부에 따라 자연적/인위적 관찰로 나누어진다.
관찰시기가 행동발생과 일치하는가 여부에 따라 체계적/비체계적 관찰로 나누어진다.
피관찰자가 관찰사실을 알고 있는가 여부에 따라 공개적/비공개적 관찰로 나누어진다.
관찰주체 또는 도구가 무엇인가에 따라 인간의 직접적/기계를 이용한 관찰로 나누어진다.
관찰시기가 행동발생과 일치하는지 여부는 직접관찰과 간접관찰을 구분하는 기준이며, 체계적/비체계적 관찰의 기준이 아니다.
체계적 관찰과 비체계적 관찰은 표준화된 관찰 도구와 절차를 사용하는지 여부에 따라 구분된다.
나머지 기준들은 관찰법의 타당한 분류기준이다. 상황의 인위성 여부에 따라 자연적/인위적 관찰로, 피관찰자의 인지 여부에 따라 공개적/비공개적 관찰로, 관찰주체·도구에 따라 인간의 직접관찰/기계를 이용한 관찰로 나뉜다.
오류나 개정된 내용이 보이면 알려주세요
다음 중 작업가설로 가장 적절한 것은?
한국 사회는 양극화되고 있다.
대학생들은 독서를 많이 해야 한다.
경제성장은 사회혼란을 심화시킬 수 있다.
소득수준이 높아질수록 생활에 대한 만족도는 높아진다.
작업가설은 변수 간의 관계를 구체적이고 검증 가능한 형태로 진술한 것이다. 소득수준과 생활만족도라는 두 변수 사이의 관계를 명확히 서술한 진술이 이에 해당한다.
오류나 개정된 내용이 보이면 알려주세요
다음 중 온라인(on-line) 조사의 장점과 가장 거리가 먼 것은?
시각적 자료를 활용할 수 있다.
민감한 주제를 다룰 수 있다.
응답자가 광범위하여, 표본의 대표성을 확보할 수 있다.
조사비용을 절감할 수 있다.
온라인 조사는 인터넷을 이용하는 사람만을 대상으로 하므로 표본의 대표성을 확보하기 어렵다는 것이 대표적인 한계로 지적된다.
시각자료 활용, 민감한 주제에 대한 응답 부담 완화, 조사비용 절감은 온라인 조사가 갖는 실질적인 장점이다.
오류나 개정된 내용이 보이면 알려주세요
가설설정 시 유의해야 할 사항으로 틀린 것은?
가설은 경험적으로 검증할 수 있어야 한다.
연구문제를 해결할 수 있어야 한다.
동의반복적(tautological)이어야 한다.
검증결과는 가능한 한 광범위하게 적용될 수 있어야 한다.
가설은 동의반복적(tautological)이지 않아야 한다. 정의상 참이 되어 버리는 순환적 진술은 경험적으로 검증할 대상이 없으므로 과학적 가설이 될 수 없다.
경험적 검증 가능성, 연구문제 해결에의 기여, 검증결과의 광범위한 적용 가능성은 좋은 가설이 갖추어야 할 조건들이다.
오류나 개정된 내용이 보이면 알려주세요
양적조사와 질적조사의 사례로 틀린 것은?
질적조사 - 사례연구의 기록을 분석하여 핵심적 개념을 추출함
양적조사 - 단일사례조사로 청소년들의 흡연횟수를 3개월 동안 주기적으로 기록함
질적조사 - 노숙인과 함께 2주간 생활하면서 참여관찰함
양적조사 - 초점집단면접을 통해 문제해결방안을 도출함
초점집단면접(FGI)은 소수의 참여자를 대상으로 심층 논의를 이끌어내는 대표적인 질적조사 기법이므로, 이를 양적조사 사례로 든 진술이 틀렸다.
단일사례조사로 흡연횟수를 주기적으로 계량화하여 기록하는 것은 양적조사에, 사례연구 기록 분석이나 참여관찰은 질적조사에 해당한다.
오류나 개정된 내용이 보이면 알려주세요
복잡한 현상에 대한 응답유형을 알아보기 위해, 탐색적 예비조사(pilot study)에 적합한 질문형식은?
개방형 질문
폐쇄형 질문
부호화 질문
범주형 질문
복잡한 현상에 대한 다양한 응답 유형을 미리 파악하려는 탐색적 예비조사에는 응답자가 자유롭게 답할 수 있는 개방형 질문이 적합하다.
폐쇄형·부호화·범주형 질문은 이미 응답 범주가 정해져 있어, 예상하지 못한 응답 유형을 발견하는 탐색 목적에는 맞지 않는다.
오류나 개정된 내용이 보이면 알려주세요
양적연구와 비교한 질적연구에 관한 설명으로 옳은 것은?
일반화의 가능성이 높다.
연역적 방법으로 자료를 분석한다.
변수 간의 관계 검증, 이론 검증 등에 유용하게 활용될 수 있다.
자료수집 단계와 자료 분석 단계가 분명히 구별되지 않는다.
질적연구는 자료를 수집하면서 동시에 분석과 해석이 이루어지는 경우가 많아, 자료수집 단계와 자료 분석 단계가 분명히 구별되지 않는다.
오류나 개정된 내용이 보이면 알려주세요
솔로몬 연구설계에 관한 옳은 설명을 모두 짝지 은 것은?
A, B, C
A, C
B, D
A, B, C, D
솔로몬 설계는 네 집단으로 구성되고, 사후측정만 하는 집단이 두 개이며, 검사와 개입의 상호작용효과를 가려낼 수 있다는 설명이 옳다.
구성은 사전검사·처치·사후검사를 모두 하는 집단, 사전검사와 사후검사만 하는 집단, 처치와 사후검사만 하는 집단, 사후검사만 하는 집단의 4개다. 뒤의 두 집단이 사전검사 없이 사후측정만 하므로 사후측정만 하는 집단은 2개가 된다.
사전검사를 받은 집단과 받지 않은 집단을 나란히 두기 때문에, 사전검사 경험이 처치의 효과를 키우거나 줄이는 검사×개입 상호작용을 분리해 확인할 수 있다는 것이 이 설계의 가장 큰 강점이다.
다만 솔로몬 설계는 통제집단 사전사후검사설계와 통제집단 사후검사설계를 결합한 형태이지, 무작위 배정을 하지 않는 비동일 비교집단설계를 합친 것이 아니므로 그 설명은 틀렸다.
오류나 개정된 내용이 보이면 알려주세요
조작적 정의(operational definition)에 관한 설명으로 옳은 것은?
연구자마다 특정 구성개념에 대한 조작적 정의는 동일해야 한다.
구성개념에 대한 이론적이고 추상적인 정의를 일컫는다.
구성개념의 조작적 정의가 구체적일수록 후속 연구에서 재현하기가 어렵다.
구성개념에 대한 조작적 정의가 연구마다 다를 경우, 연구결과가 달라질 수 있다.
구성개념을 측정 가능하도록 구체화한 것이 조작적 정의이며, 이는 연구자나 연구 상황에 따라 달리 내려질 수 있고 그 차이는 결과적으로 연구결과의 차이로 이어질 수 있다.
오류나 개정된 내용이 보이면 알려주세요
전문직에 종사하는 남성근로자를 대상으로 하는 사회조사에서 변수가 될 수 없는 것은?
연령
성별
직업종류
근무시간
조사대상을 이미 전문직 종사 남성근로자로 한정했으므로, 이 표본 안에서 성별은 값이 하나로 고정되어 변하지 않는다. 값이 변하지 않는 속성은 변수가 아니라 상수이다.
연령, 직업종류, 근무시간은 같은 조사대상 안에서도 개인별로 다른 값을 가지므로 변수로 사용될 수 있다.
오류나 개정된 내용이 보이면 알려주세요
표본의 크기에 관한 설명으로 틀린 것은?
표본의 크기는 전체적인 조사목적, 비용 등을 감안하여 결정한다.
부분집단별 분석이 필요한 경우에는 표본의 수를 작게 하는 대신 무응답을 줄이려고 노력한다.
일반적으로 표본의 크기가 증가할수록 표본오차의 크기는 감소한다.
비확률 표본추출법의 경우, 표본의 크기와 표본 오차와는 무관하다.
부분집단(하위집단)별 분석이 필요한 경우에는 각 집단에서 충분한 사례수를 확보해야 하므로 오히려 표본의 수를 늘려야 한다. 표본 수를 줄이면서 무응답만 줄이려 한다는 진술은 틀렸다.
조사목적과 비용을 고려해 표본크기를 정한다는 것, 표본이 클수록 표본오차가 작아진다는 것, 비확률표본추출에서는 표본크기와 표본오차의 관계를 통계적으로 논하기 어렵다는 것은 모두 옳은 설명이다.
오류나 개정된 내용이 보이면 알려주세요
측정 오류에 관한 설명으로 틀린 것은?
체계적 오류는 사회적 바람직성 편견과 문화적 편견과 관련이 있다.
무작위적 오류는 일관적 영향 패턴을 가지지 않고, 측정을 일관성 없게 만든다.
측정의 신뢰도는 체계적 오류와 관련성이 크고, 측정의 타당도는 무작위적 오류와 관련성이 크다.
측정의 오류를 피하기 위해 간과했을 수도 있는 편견이나 모호함을 찾아내기 위해 동료들의 피드백을 얻는다.
측정의 신뢰도는 무작위적(비체계적) 오류와 관련이 크고, 측정의 타당도는 체계적 오류와 관련이 크다. 이 관계가 뒤바뀌어 서술된 것이 틀린 부분이다.
체계적 오류는 사회적 바람직성 편견처럼 일정한 방향으로 측정값을 왜곡시켜 타당도를 떨어뜨리고, 무작위적 오류는 일관성 없이 흩어지는 오차로 신뢰도를 떨어뜨린다. 동료 피드백으로 편견이나 모호함을 찾아내려는 노력은 오류를 줄이는 타당한 방법이다.
오류나 개정된 내용이 보이면 알려주세요
표본추출과 관련된 용어 설명으로 틀린 것은?
관찰단위 : 직접적인 조사대상
모집단 : 연구하고자 하는 이론상의 전체집단
표집률 : 모집단에서 개별 요소가 선택될 비율
통계량(statistic) : 모집단에서 어떤 변수가 가지고 있는 특성을 요약한 통계치
통계량(statistic)은 표본에서 계산된 특성값을 의미하며, 모집단이 가지고 있는 특성을 요약한 값은 모수(parameter)라고 부른다. 이 정의가 뒤바뀐 것이 틀린 설명이다.
관찰단위를 직접적인 조사대상으로, 모집단을 연구하고자 하는 이론상의 전체집단으로, 표집률을 모집단에서 개별 요소가 선택될 비율로 정의한 것은 모두 옳다.
오류나 개정된 내용이 보이면 알려주세요
표본추출과정을 바르게 나열한 것은?
E → C → D → B → A
E → B → C → D → A
E → D → B → C → A
E → C → B → D → A
표본추출은 모집단의 확정 → 표본틀의 결정 → 표본추출방법의 결정 → 표본의 크기결정 → 표본추출 순서로 진행되므로 E → B → C → D → A 가 된다.
먼저 조사 대상이 되는 모집단을 명확히 규정해야(E) 그 모집단을 대표하는 명부인 표본틀을 마련할 수 있다(B). 표본틀이 갖춰져야 확률표본추출을 쓸지 비확률표본추출을 쓸지 등 표본추출방법을 정할 수 있다(C).
추출방법이 정해지면 허용오차·신뢰수준·조사비용을 고려해 표본의 크기를 산정하고(D), 마지막으로 실제 표본을 뽑는다(A).
표본틀을 정하기 전에 크기부터 정하거나 추출방법을 정하기 전에 표본을 먼저 뽑는 순서는 성립하지 않는다는 점이 오답 판별의 기준이 된다.
오류나 개정된 내용이 보이면 알려주세요
다음 내용에서 설명하고 있는 척도는?
리커트(Likert) 척도
거트만(Guttman) 척도
서스톤(Thurstone) 척도
의미분화(Semantic Differential) 척도
제시된 세 진술은 모두 리커트(Likert) 척도의 특징이다.
리커트 척도는 여러 문항이 동일한 개념을 같은 비중으로 측정한다고 보고, 각 문항의 응답점수를 단순 합산한 총점으로 그 개념을 대표시키는 총화평정(summated rating) 척도다. '각 문항이 동일한 기여를 한다', '응답점수의 총합이 개념을 대표한다'는 진술이 바로 이 가정을 가리킨다.
또 문항 간 내적 일관성(크론바흐 α, 문항-총점 상관)을 검토해 일관성을 떨어뜨리는 문항을 삭제하는 문항 정련 절차도 리커트 척도의 표준 방법이다.
오류나 개정된 내용이 보이면 알려주세요
야구선수의 등번호를 표현하는 측정의 수준은?
비율수준의 측정
등간수준의 측정
서열수준의 측정
명목수준의 측정
등번호는 선수를 구별하기 위한 이름표에 불과하며, 숫자의 크기나 순서에 아무런 의미가 없다. 이러한 분류·구별 목적의 측정은 명목수준의 측정에 해당한다.
등번호 숫자 간에는 크기 비교, 간격, 비율 계산이 성립하지 않으므로 서열·등간·비율수준의 측정과는 구별된다.
오류나 개정된 내용이 보이면 알려주세요
동일대상에게 시기만 달리하여, 동일 측정도구로 조사한 결과를 비교하는 신뢰도 측정방법은?
재검사법(test-retest method)
복수양식법(parallel-forms technique)
반분법(split-half method)
내적 일관성법(internal consistency)
동일한 대상에게 동일한 측정도구로 시간 간격을 두고 두 번 측정하여 그 결과의 일치도를 확인하는 신뢰도 검증방법은 재검사법(test-retest method)이다.
복수양식법은 유사한 두 가지 도구로, 반분법과 내적 일관성법은 하나의 측정도구 문항들을 나누어 상관을 보는 방식으로, 시기를 달리한 반복측정과는 방법이 다르다.
오류나 개정된 내용이 보이면 알려주세요
다음 중 비율척도로 측정하기 어려운 것은?
각 나라의 평균 기온
각 나라의 1인당 평균 소득
각 나라의 1인당 교육년수
각 나라의 국방 예산
섭씨·화씨로 표시하는 기온은 0도가 '온도가 전혀 없음'을 뜻하지 않는 임의의 기준점이어서 절대영점이 존재하지 않는다. 따라서 기온은 등간척도에 가까워 비율척도로 측정하기 어렵다.
1인당 소득, 1인당 교육년수, 국방 예산은 모두 0이 '없음'을 의미하는 절대영점을 가지므로 비율척도로 측정할 수 있다.
오류나 개정된 내용이 보이면 알려주세요
총 학생수가 2,000명인 학교에서 800명을 표집할 때의 표집률은?
25%
40%
80%
100%
표집률은 모집단 중에서 표본으로 뽑힌 비율이므로, 표집한 인원을 모집단 전체 인원으로 나누어 구한다.
오류나 개정된 내용이 보이면 알려주세요
다음은 어떤 표본추출법에 해당하는가?
모집단의 크기가 10만 명이고 표본의 크기가 1,000명일 때, 최초 1번에서 100번 사이에서 무작위로 한 사람을 고르고, 그 다음부터는 100의 표집간격으로 추출하였다.
단순무작위(simple random)표본추출
계통(systematic)표본추출
층화(stratified)표본추출
집락(cluster)표본추출
표집간격 100을 정하고 첫 번째 요소만 무작위로 고른 뒤 그 간격마다 뽑았으므로 계통(systematic)표본추출이다.
계통추출은 표집간격 을 먼저 구하고, 1~100 중 무작위로 시작점 하나를 고른 다음 100번째마다 요소를 뽑는다. 무작위성이 시작점 한 번에만 개입한다는 점이 이 방법의 결정적 특징이다.
오류나 개정된 내용이 보이면 알려주세요
다음 중 모집단을 정확하게 규정하기 위해 고려해야 하는 요소와 가장 거리가 먼 것은?
경제성
표본단위
조사지역
조사기간
모집단을 정확히 규정하려면 조사대상이 되는 요소들을 특정하는 표본단위, 조사 범위인 조사지역, 조사 시점인 조사기간을 명확히 해야 한다. 반면 경제성은 조사비용·효율성에 관한 고려사항으로, 모집단의 범위 자체를 규정하는 요소와는 성격이 다르다.
오류나 개정된 내용이 보이면 알려주세요
다음은 어떤 척도에 관한 설명인가?
우리나라의 특정 정치지도자에 대한 국민의 생각을 측정하기 위한 방법으로 ‘정직 - 부정직, 긍정적 - 부정적, 약하다 - 강하다, 능동적 - 수동적’ 등과 같은 대칭적 형용사를 제시한 후 응답자들로 하여금 이들 각각의 문항에 대해 1부터 7까지의 연속선상에서 평가하도록 하였다.
서스톤척도
거트만척도
리커트척도
의미분화척도
대칭되는 형용사 쌍을 양극에 놓고 그 사이 연속선 위에 평가하게 하는 방식은 의미분화(semantic differential) 척도다.
지문은 '정직-부정직', '긍정적-부정적', '약하다-강하다', '능동적-수동적'처럼 상반된 형용사 쌍을 제시하고 1부터 7까지의 연속선상에서 평가하게 했다. 오스굿이 개발한 이 척도는 대상에 대해 사람들이 갖는 의미의 차원(평가·능력·활동)을 측정하는 데 쓰인다.
오류나 개정된 내용이 보이면 알려주세요
측정에서 비체계적 오차와 체계적 오차를 신뢰도와 타당도의 개념과 연결시켜 생각할 때, 타당도는 높으나 신뢰도가 낮은 경우는 어디에 해당하는가?
비체계적 오차가 작고 체계적 오차가 작을 경우
비체계적 오차가 크고 체계적 오차가 작을 경우
비체계적 오차가 작고 체계적 오차가 클 경우
비체계적 오차가 크고 체계적 오차가 클 경우
비체계적 오차는 무작위로 흩어지는 오차로 신뢰도를 떨어뜨리고, 체계적 오차는 일정한 방향으로 측정값을 치우치게 만들어 타당도를 떨어뜨린다.
따라서 타당도는 높으면서 신뢰도가 낮은 경우는 체계적 오차는 작지만 비체계적 오차가 큰 경우에 해당한다.
오류나 개정된 내용이 보이면 알려주세요
다음 설문문항은 어떤 척도를 활용한 것인가?
※ 각 집단에 대해 귀하는 어느 수준까지 받아들일 수 있는지 선택하여 주십시오.
| 문항 | 영국인 | 스위스인 | 일본인 |
|---|---|---|---|
| 1. 결혼하여 가족으로 받아들임 | |||
| 2. 개인적 친구로 받아들임 | |||
| … | |||
| 6. 방문객으로 받아들임 | |||
| 7. 우리나라에서 추방함 |
총화평정(summated rating)척도
사회적거리감(social distance)척도
서스톤(Thurstone)척도
리커트(Likert)척도
여러 집단에 대해 결혼·친구·방문객·추방처럼 수용 수준이 단계적으로 배열된 문항을 제시하는 것은 보가더스의 사회적거리감(social distance) 척도다.
제시된 설문은 영국인·스위스인·일본인 각각에 대해 '결혼하여 가족으로 받아들임 → 개인적 친구로 받아들임 → … → 방문객으로 받아들임 → 우리나라에서 추방함'까지 친밀도가 점차 약해지는 7단계를 놓고 어느 수준까지 받아들일 수 있는지 고르게 한다. 집단 간 심리적 거리를 재는 전형적인 형식이다.
문항들이 강도 순으로 배열되어 누적적 성격을 갖기 때문에 응답 하나로 그 집단에 대한 수용 수준이 결정된다는 점도 이 척도의 특징이다.
오류나 개정된 내용이 보이면 알려주세요
다음 ( )에 알맞은 것은?
지식경제부 산하 공공기관 채용시험에서 A의 성적은 높았고 B의 성적은 낮았지만 두 사람 모두 같은 공공기관에 입사했다. 입사 후에 B가 A보다 업무능력이 뛰어난 것으로 나타난다면, 이 기관에서 사용한 채용시험의 ( )타당도는 낮다고 할 수 있다.
내용(content)
수렴(convergent)
판별(discriminant)
예측(predictive)
시험 성적이 입사 후 실제 업무능력을 제대로 맞추지 못했으므로 낮다고 평가되는 것은 예측(predictive) 타당도다.
예측타당도는 측정도구의 점수가 미래에 관찰될 기준행동(준거)을 얼마나 잘 예측하는지로 평가한다. 지문에서 채용시험의 준거는 입사 후 업무능력인데, 성적이 높았던 사람보다 낮았던 사람의 업무능력이 뛰어났으므로 시험점수와 준거의 관계가 오히려 역전된 셈이다.
오류나 개정된 내용이 보이면 알려주세요
연구자들의 가설에 포함된 변수들에 관한 옳은 설명을 <보기>에서 모두 짝지은 것은?
연구자들은 학생들의 학업부진이 비행친구와 사귀도록 만들고 이것이 비행으로 이어진다고 본다. 그러나, 학업이 부진한 학생이라도 학교선생님의 관심을 받으면 비행가능성이 줄어들 수 있다고 본다. 그런데, 학생들의 어릴 적 가정환경이 비행을 설명하는 가장 중요한 원인일 것이라는 또 다른 연구자들의 가설이 있다.
< 보 기 >
B, D
A, B, C
A, C, D
A, B, C, D
제시된 A~D 진술이 모두 옳다.
가설의 인과 사슬은 '학업부진 → 비행친구와 사귐 → 비행'이다. 원인 자리의 학업부진이 독립변수, 결과 자리의 비행이 종속변수이며, 그 사이에서 영향을 전달하는 비행친구와의 사귐은 매개변수다.
'학업이 부진한 학생이라도 선생님의 관심을 받으면 비행가능성이 줄어든다'는 진술은 선생님의 관심이 독립변수와 종속변수의 관계 강도를 바꾼다는 뜻이므로 조절변수에 해당한다.
'어릴 적 가정환경이 비행을 설명하는 가장 중요한 원인'이라는 또 다른 연구자들의 가설은 원래 모형 밖에 있으면서 종속변수에 영향을 주는 변수를 지목한 것이므로 외생변수로 본다.
오류나 개정된 내용이 보이면 알려주세요
표본추출의 대표성에 관한 설명으로 틀린 것은?
대표성의 문제란 표본이 모집단을 대표하여 일반화가 가능한 것인가의 문제이다.
표본추출에는 우연성이 많아야 대표성이 확보된다.
표본은 모집단과 변수의 특성이 유사한 분포를 갖도록 추출되어야 한다.
조사에 있어 어떤 것이 중요한 가설인가에 따라 대표성이 달라진다.
표본이 모집단을 대표하려면 모집단의 모든 구성요소가 정해진 확률로 추출되는 확률표본추출과 같은 체계적인 절차를 따라야 하며, 단순히 우연성이 많다고 해서 대표성이 확보되는 것은 아니다.
대표성이 표본의 일반화 가능성 문제라는 것, 모집단과 유사한 분포를 갖도록 추출해야 한다는 것, 어떤 가설이 중요한가에 따라 필요한 대표성의 수준이 달라진다는 것은 모두 옳은 설명이다.
오류나 개정된 내용이 보이면 알려주세요
측정도구의 타당도에 관한 설명으로 틀린 것은?
내용타당도(content validity)는 전문가의 판단에 기초한다.
구성타당도(construct validity)는 예측타당도 (predictive validity)라 한다.
동시타당도(concurrent validity)는 신뢰할 수 있는 다른 측정도구와 비교하는 것이다.
기준관련 타당도(criterion-related validity)는 내용타당도보다 경험적 검증이 용이하다.
예측타당도(predictive validity)는 미래의 행동이나 결과를 얼마나 잘 예측하는지를 보는 것으로, 기준관련 타당도의 한 유형이지 구성타당도와는 별개의 개념이다.
내용타당도가 전문가 판단에 기초한다는 것, 동시타당도가 신뢰할 수 있는 다른 척도와 비교하는 방식이라는 것, 기준관련 타당도가 내용타당도보다 경험적으로 검증하기 쉽다는 것은 옳은 설명이다.
오류나 개정된 내용이 보이면 알려주세요
다음 중 모집단의 모든 표집단위가 표본에 선정될 수 있는 확률 명확히 규정할 수 없고, 각 표집단위의 추출확률 또한 동일하지 않은 표집방법은?
단순 무작위 (simple random sampling)
할당표집(quota sampling)
체계적 표집(systematic sampling)
층화표집(stratified sampling)
모집단 구성요소가 표본에 뽑힐 확률을 명확히 규정할 수 없고 각 요소의 추출확률도 동일하지 않은 표집방법은 할당표집(quota sampling)과 같은 비확률표집이다.
단순무작위표집·체계적표집·층화표집은 모두 각 표집단위의 추출확률이 사전에 알려진 확률표집 방법이다.
오류나 개정된 내용이 보이면 알려주세요
서열측정의 특징을 모두 짝지은 것은?
A
A, B
B, C
A, B, C
서열측정의 특징은 응답자들을 순서대로 구분할 수 있다는 것 하나뿐이다.
서열척도는 크고 작음의 순위 정보만 담는다. 1등·2등·3등처럼 순서는 매길 수 있으나 등급 사이의 간격이 같다는 보장이 없어 차이의 크기나 배수는 해석할 수 없다.
오류나 개정된 내용이 보이면 알려주세요
척도구성방법을 비교척도구성(comparative scaling)과 비비교척도구성(non-comparative scaling)으로 구분할 때 비교척도구성에 해당하는 것은?
A, B, C
A, C, E
D, E
A, B, C, D, E
비교척도구성에 해당하는 것은 쌍대비교법·순위법·고정총합법이다.
비교척도구성(comparative scaling)은 응답자가 둘 이상의 대상을 서로 견주어 판단하게 하는 방식이다. 쌍대비교법은 두 대상을 짝지어 어느 쪽이 나은지 고르게 하고, 순위법은 대상들에 순위를 매기게 하며, 고정총합법은 100점처럼 정해진 총점을 대상들에 나눠 배분하게 한다. 결과가 상대적인 서열 정보로 나온다는 공통점이 있다.
반면 연속평정법과 항목평정법은 다른 대상과 견주지 않고 대상을 하나씩 독립적으로 척도선이나 항목 위에 평가하게 하는 비비교척도구성(non-comparative scaling)이므로 여기에 포함되지 않는다.
오류나 개정된 내용이 보이면 알려주세요
서스톤(Thurstone)척도는 척도의 수준으로 볼 때, 다음 중 어느 척도에 해당하는가?
등간척도
서열척도
명목척도
비율척도
서스톤(Thurstone) 척도는 여러 진술문에 대해 전문가 평가를 통해 척도값(가중치)을 부여하여 진술문 간의 간격이 동일하다고 가정하는 척도로, 등간척도 수준에 해당한다.
오류나 개정된 내용이 보이면 알려주세요
층화(stratified)표본추출법에 관한 설명으로 틀린 것은?
모집단을 일정 기준에 따라 서로 상이한 집단들로 재구성 한다.
동질적인 집단에서의 표집오차가 이질적인 집단에서의 오차보다 작다는데 논리적인 근거를 둔다.
비례층화추출법과 불비례층화추출법으로 구분할 수 있다.
집단간에 이질성이 존재하는 경우 무작위표본추출보다 정확하게 모집단을 대표하지 못하는 단점이 있다.
층화표본추출은 동질적인 집단(층) 내에서는 표집오차가 작다는 논리에 근거하며, 오히려 집단 간에 이질성이 클수록 각 층을 대표적으로 반영해 무작위표본추출보다 모집단을 더 정확하게 대표할 수 있다는 장점이 있다.
모집단을 일정 기준으로 재구성한다는 것, 비례·불비례층화추출법으로 나뉜다는 것은 옳은 설명이다.
오류나 개정된 내용이 보이면 알려주세요
다음 중 표본의 크기를 결정하는 요인과 가장 거리가 먼 것은?
조사목적
조사비용
분석기법
집단별 통계치의 필요성
표본크기는 조사목적, 조사비용, 집단별 통계치가 필요한 정도 등을 종합적으로 고려해 결정한다. 반면 분석기법은 표본이 확보된 이후 자료를 어떻게 처리할지의 문제로, 표본크기 자체를 결정하는 요인과는 거리가 멀다.
오류나 개정된 내용이 보이면 알려주세요
신뢰도는 과학적 연구의 요건 중 어느 것과 가장 관련이 깊은가?
논리성
검증가능성
반복가능성
일반성
신뢰도는 동일한 조건에서 같은 결과를 다시 얻을 수 있는가, 즉 반복가능성과 가장 밀접하게 관련된 과학적 연구의 요건이다.
논리성, 검증가능성, 일반성은 각각 이론의 정합성, 경험적 검증, 결과의 확장 적용 가능성과 관련된 다른 요건들이다.
오류나 개정된 내용이 보이면 알려주세요
집락(cluster)표본추출법에 관한 설명으로 틀린 것은?
선정된 각 집락은 다른 조사의 표본으로도 사용 할 수 있다.
모집단의 목록이 없는 경우에 매우 유용하다.
단순무작위표본추출법에 비해서 시간과 비용면 에서 효율적이다.
집락 단계의 수가 많을수록 표본 오차(sampling error)가 작아지게 된다.
집락표본추출에서 집락(단계)의 수가 많아질수록 표본 구성이 특정 집락에 편중될 가능성이 커져 오히려 표본오차가 커지는 경향이 있다. 단계 수가 많을수록 오차가 작아진다는 진술이 틀렸다.
선정된 집락을 다른 조사에도 활용할 수 있다는 것, 모집단 목록이 없을 때 유용하다는 것, 단순무작위표집보다 시간·비용 면에서 효율적이라는 것은 집락표집의 실제 특징이다.
오류나 개정된 내용이 보이면 알려주세요
개념적 정의에 관한 설명으로 틀린 것은?
순환적인 정의를 해야 한다.
적극적 혹은 긍정적인 표현을 써야 한다.
정의하려는 대상이 무엇이든 그것만의 특유한 요소나 성질을 적시해야 한다.
뜻이 분명해서 누구나 알아들을 수 있는 의미를 공유하는 용어를 써야 한다.
개념적 정의는 정의하려는 대상 자체를 다시 사용해 설명하는 순환적(tautological) 정의를 피해야 한다. 순환적 정의를 해야 한다는 진술은 틀렸다.
긍정적·적극적 표현을 사용해야 한다는 것, 대상의 고유한 특성을 적시해야 한다는 것, 누구나 공유할 수 있는 분명한 용어를 써야 한다는 것은 개념적 정의가 갖추어야 할 조건들이다.
오류나 개정된 내용이 보이면 알려주세요
척도의 신뢰도를 파악하는 방법이 아닌 것은?
하나의 척도를 동일인에 대하여 두 번 이상 반복하여 측정한다.
한 측정도구의 전체문항들을 반씩 나누어 두 부분간의 상관성을 측정한다.
여러 평가자들을 통해 얻은 측정 결과들간의 일치도를 비교한다.
측정점수를 몇 가지 다른 기준과 비교하여 일치 되는 정도를 측정한다.
측정점수를 다른 기준(외부 준거)과 비교해 일치 정도를 보는 것은 기준관련 타당도를 검증하는 방법이지, 신뢰도를 파악하는 방법이 아니다.
동일인을 반복 측정해 비교하는 재검사법, 문항을 반으로 나눠 상관을 보는 반분법, 여러 평가자 간 일치도를 비교하는 방법은 모두 신뢰도를 파악하는 대표적인 방법들이다.
오류나 개정된 내용이 보이면 알려주세요
두 확률변수 X, Y의 상관계수를 p 라 할 때, 다음 중 틀린 것은?
-1≤ p ≤1 이다.
p가 0이면, 언제나 X, Y는 서로 독립이다.
p는 X, Y의 선형관계에 대한 측도이다.
p= Cov(X,Y)/(σxσy) 이다. 단, σ는 표준편차를 나타낸다.
상관계수 가 0이라는 것은 선형관계가 없다는 의미일 뿐, X와 Y 사이에 비선형적인 관계가 존재할 수 있으므로 항상 독립이라고 단정할 수는 없다.
상관계수가 범위를 가진다는 것, 선형관계의 정도를 나타내는 측도라는 것, 로 정의된다는 것은 모두 옳다.
오류나 개정된 내용이 보이면 알려주세요
4개의 불량품과 3개의 양호품이 들어있는 상자에서 2개의 제품을 비 복원으로 꺼낼 때, 불량품이 적어도 1개일 확률은?
9/42
21/42
1/7
6/7
비복원으로 2개를 꺼낼 때 적어도 1개가 불량품일 확률은 여사건인 '2개 모두 양호품'일 확률을 1에서 빼서 구한다.
모두 양호품일 확률은 이다.
따라서 적어도 1개가 불량품일 확률은 이다.
오류나 개정된 내용이 보이면 알려주세요
A반 학생은 50명이고 B반 학생은 100명이다. A반과 B반의 평균성적이 각각 80점과 85점이었다. A반과 B반을 합한 전체 평균성적은?
80.0
82.5
83.3
84.5
두 반을 합친 전체 평균은 각 반의 인원수를 가중치로 하는 가중평균으로 구한다.
오류나 개정된 내용이 보이면 알려주세요
가정 난방의 선호도와 방법에 대한 분할표가 다음과 같다. “가스난방”이 “아주 좋다”에 응답한 셀의 기대도수를 구하면?
| 선호도 \ 난방 | 기름 | 가스 | 기타 |
|---|---|---|---|
| 아주 좋다 | 20 | 30 | 20 |
| 적당하다 | 15 | 40 | 35 |
| 좋지 않다 | 50 | 20 | 10 |
31.25
28.25
32.45
26.25
기대도수는 로 구하며, 그 값은 26.25다.
분할표를 기름·가스·기타 순으로 읽으면 '아주 좋다' 20·30·20, '적당하다' 15·40·35, '좋지 않다' 50·20·10이다.
'아주 좋다' 행 합계 = 20+30+20 = 70
'가스' 열 합계 = 30+40+20 = 90
세 행의 합계는 각각 70·90·80이므로 전체 합계 = 240따라서 이다.
관측도수 30을 그대로 쓰거나 행·열 합계를 잘못 잡으면 엉뚱한 값이 나오므로, 해당 행 합계와 열 합계, 총합을 먼저 정확히 계산하는 것이 요령이다.
오류나 개정된 내용이 보이면 알려주세요
3개 이상의 모집단의 모평균을 비교하는 통계적 방법으로 가장 적합한 것은?
t-검정
회귀분석
분산분석
상관분석
3개 이상의 모집단에서 모평균의 차이를 동시에 비교하는 통계적 방법은 분산분석(ANOVA)이다.
t-검정은 두 집단 간 평균 비교에, 회귀분석과 상관분석은 변수 간의 관계를 파악하는 데 사용되는 방법으로 목적이 다르다.
오류나 개정된 내용이 보이면 알려주세요
A 분포와 B 분포의 특성에 관한 설명으로 틀린 것은?
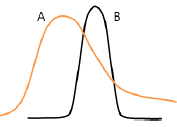
A의 최빈값은 B의 최빈값보다 작다.
A의 분산은 B의 분산보다 크다.
A의 왜도는 양(+)의 값을 가진다.
B의 왜도는 음(-)의 값을 가진다.
B 분포는 왼쪽으로 꼬리가 길게 늘어진 모양이 아니므로 왜도가 음(-)의 값을 갖는다고 볼 수 없다.
그림에서 A는 봉우리가 왼쪽에 있고 오른쪽으로 긴 꼬리가 완만하게 뻗어 나가는 형태이고, B는 봉우리가 A보다 오른쪽에 있으면서 좌우 꼬리가 모두 짧고 폭이 좁은 뾰족한 형태다.
음(-)의 왜도는 왼쪽으로 꼬리가 길게 늘어진 분포에서 나타나는데, 좌우 꼬리 길이가 비슷한 B는 그런 모습이 아니다.
오류나 개정된 내용이 보이면 알려주세요
국회의원 후보 A 에 대한 청년층 지지율 p1과 노년층 지지율 p2 의 차이 p1-p2는 6.6%로 알려져 있다. 청년층과 노년층 각각 500명 씩을 랜덤 추출하여 조사하였더니, 위 지지율 차이는 3.3%로 나타났다. 지지율 차이가 줄어들었다고 할 수 있는지를 검정하기 위한 귀무가설 H0 와 대립가설 H1은?
H0:p1-p2 = 0.033, H1:p1-p2 > 0.033
H0:p1-p2 > 0.033, H1:p1-p2 ≤ 0.033
H0:p1-p2 < 0.066, H1:p1-p2 ≥ 0.066
H0:p1-p2 = 0.066, H1:p1-p2 < 0.066
기존에 알려진 지지율 차이는 이며, 이번 조사에서 관찰된 차이가 이보다 줄어들었는지를 검정하려는 것이므로 귀무가설은 기존 값을 그대로 두고 대립가설은 그보다 작다는 방향으로 세운다.
오류나 개정된 내용이 보이면 알려주세요
국회의원 선거에 출마한 A 후보의 지지율이 50%를 넘는지 확인하기 위해 유권자 1,000명을 조사 하였더니 550명이 A 후보를 지지하였다. 귀무가설 H0:p = 0.5 대 대립가설 H1 > 0.5의 검정을 위한 검정통계량 Z0는?
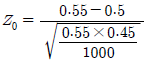
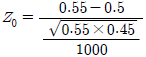
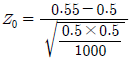
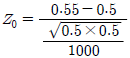
모비율 검정의 검정통계량은 귀무가설의 비율 로 표준오차를 계산하므로 형태가 된다.
표본비율은 이고, 검정통계량의 일반형은 이다.
분모의 표준오차는 귀무가설이 참이라는 가정 아래 계산하므로 표본비율 0.55가 아니라 가설값 0.5를 넣어야 한다. 따라서 분모에 를 쓴 식들은 이 원칙에 어긋난다.
또 표준오차는 표본크기 이 제곱근 안에 들어가야 하므로, 제곱근을 씌운 뒤 다시 1000으로 나눈 형태의 식도 성립하지 않는다. 실제 값은 이다.
오류나 개정된 내용이 보이면 알려주세요
독립변수가 2개인 중회귀모형의 유의성 검정에 대한 설명으로 틀린 것은?
H0 : β1 = β2 = 0
H1 : 회귀계수 β1, β1 중 적어도 하나는 0이 아니다.
이면 H0 을 기각한다.
유의확률 p가 유의수준 α 보다 작으면 H0 을 기각한다.
회귀모형의 유의성 검정은 회귀 평균제곱을 오차 평균제곱으로 나눈 을 검정통계량으로 쓰므로, 분자와 분모를 뒤집어 일 때 귀무가설을 기각한다고 한 설명이 틀렸다.
독립변수가 2개인 중회귀모형에서 귀무가설은 두 회귀계수가 모두 0이라는 이고, 대립가설은 적어도 하나의 회귀계수가 0이 아니다가 되어 모형 전체의 설명력을 한꺼번에 묻는다.
기각 판정은 이거나, 같은 뜻으로 유의확률 p가 유의수준 α보다 작을 때 귀무가설을 기각한다. 회귀로 설명되는 변동이 오차 변동보다 충분히 커야 유의하다는 논리다.
오류나 개정된 내용이 보이면 알려주세요
어떤 시험에 응시한 응시자들이 시험 문제를 모두 푸는데 걸리는 시간은 평균 60분, 표준편차 10분인 정규분포를 따른다고 한다. 이 시험의 시험시간을 50분으로 정한다면 시험에 응시한 1,000명 중 시간 내에 문제를 모두 푸는 학생은 몇 명이 되겠는가? (단, P(Z<1)=0.8413)
156
158
160
162
시험 완료시간 는 평균 60분, 표준편차 10분인 정규분포를 따르므로, 50분 이내에 마칠 확률은 을 표준화하여 구한다.
이므로 이다.
따라서 1,000명 중 시간 내에 다 푸는 학생 수는 명으로, 약 158명이다.
오류나 개정된 내용이 보이면 알려주세요
다음 중 추정량에 요구되는 바람직한 성질이 아닌 것은?
불편성(unbiasedness)
효율성(efficiency)
충분성(sufficiency)
정확성(accuracy)
추정량이 갖추어야 할 바람직한 성질로는 불편성, 효율성, 충분성, 일치성(consistency)이 제시된다.
반면 정확성(accuracy)은 추정량의 성질을 규정하는 기준으로 함께 열거되지 않는 항목이다.
오류나 개정된 내용이 보이면 알려주세요
회귀분석 결과 분산분석표에서 잔차제곱합(SSE)은 60, 총제곱합(SST)은 240임을 알았다. 이 회귀모형의 결정계수는?
0.25
0.5
0.75
0.95
결정계수는 총제곱합 중에서 회귀식으로 설명되는 비율로, 로 계산한다.
오류나 개정된 내용이 보이면 알려주세요
다음은 중회귀식 그리참조=36.69+3.37X1 의 회귀계수표이다. 다음 ( )에 알맞은 값은?
coefficients
| Model | Unstandardized Coefficients | Standardised Coefficiensts | t | Sig | |
|---|---|---|---|---|---|
| B | Std. Error | Beta | |||
| (Constants) | 39.69 | 30.72 | (A) | 0.265 | |
| 평수 | 3.37 | 0.96 | 0.85 | (B) | 0.009 |
| 가족수 | 0.53 | 6.6 | 0.02 | (C) | 0.941 |
A=1.21, B=3.59, C=0.08
A=1.29, B=3.51, C=0.08
A=10.21, B=36.2, C=0.80
A=39.69, B=3.37, C=26.5
회귀계수표의 t값은 비표준화계수 B를 그 표준오차로 나눈 값이므로 A=1.29, B=3.51, C=0.08이다.
상수항:
평수:
가족수:계산된 t값은 표의 유의확률과도 앞뒤가 맞는다. t가 3.51로 큰 평수만 유의확률 0.009로 유의수준 0.05에서 유의하고, t가 1.29·0.08로 작은 상수항(0.265)과 가족수(0.941)는 유의하지 않다.
오류나 개정된 내용이 보이면 알려주세요
다음 중 회귀분석에 관한 설명으로 틀린 것은?
회귀분석은 자료를 통하여 독립변수와 종속변수간의 함수관계를 통계적으로 규명하는 분석방법이다.
회귀분석은 종속변수의 값 변화에 영향을 미치는 중요한 독립변수들이 무엇인지 알 수 있다.
단순회귀선형모형의 오차 εi 에 대한 가정에서 εi~N(0,σ2)이며, 오차는 서로 독립이다.
최소자승법은 회귀모형의 절편과 기울기를 구하는 방법으로 잔차의 합을 최소화시킨다.
최소자승법은 잔차의 합이 아니라 잔차제곱합(오차제곱합)을 최소화하여 회귀모형의 절편과 기울기를 추정하는 방법이다.
잔차의 단순 합은 양수와 음수가 서로 상쇄되어 항상 0에 가깝게 나올 수 있으므로 최소화 기준으로 삼지 않으며, 그래서 제곱한 값을 최소화한다.
오류나 개정된 내용이 보이면 알려주세요
어떤 산업제약은 제품 중 10%는 유통과정에서 변질되어 약효를 발휘 할 수 없다고 한다. 이를 확인하기 위하여 해당 제품 100개를 추출하여 실험 하였다. 이때 10개 이상이 불량품일 확률은?
0.1
0.3
0.5
0.7
불량률이 10%인 제품 100개를 뽑았을 때 불량품 개수는 이항분포를 따르며, 평균은 , 분산은 로 정규근사를 사용한다.
표준화하면 이므로, 10개 이상이 불량품일 확률은 가 된다.
오류나 개정된 내용이 보이면 알려주세요
어떤 가설검정에서 유의확률(p값)이 0.044일 때, 검정결과로 옳은 것은?
귀무가설을 유의수준 1%와 5%에서 모두 기각 할 수 없다.
귀무가설을 유의수준 1%와 5%에서 모두 기각 할 수 있다.
귀무가설을 유의수준 1%에서 기각할 수 없으나 5%에서는 기각할 수 있다.
귀무가설을 유의수준 1%에서 기각할 수 있으나 5%에서는 기각할 수 없다.
유의확률이 0.044이면 유의수준 5%(0.05)보다는 작고 1%(0.01)보다는 크므로, 5% 수준에서는 귀무가설을 기각할 수 있지만 1% 수준에서는 기각할 수 없다.
유의확률이 유의수준보다 작을 때만 귀무가설을 기각한다는 판정 규칙을 두 유의수준에 각각 적용한 결과이다.
오류나 개정된 내용이 보이면 알려주세요
두 변수 (x,y)의 상관계수는 0.92이다. , 라 할 때, 두 변수 의 상관계수는?
0.69
-0.69
0.92
-0.92
두 변수를 각각 양의 상수배와 상수 덧셈으로 선형변환해도 상관계수는 변하지 않으므로 0.92 그대로다.
, 에서 기울기가 , 로 둘 다 양수이므로 크기뿐 아니라 부호도 유지된다.
일반적으로 이고 여기서는 이므로 답은 0.92다. 두 계수 중 하나만 음수였다면 -0.92가 되었을 것이다.
오류나 개정된 내용이 보이면 알려주세요
성인 남자 20명을 랜덤 추출하여, 소변 중 요산량(mg/dl)을 조사 하니 평균 =5.31 , 표준편차 s=0.7 이었다. 성인 남자의 요산량이 정규분포를 따른다고 할 때, 모분산 σ2에 대한 95% 신뢰구간은? ( 단, V~X2(19) 일 때 P(V≥32.85)=0.025, P(V≥8.91)=0.975)
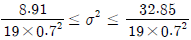
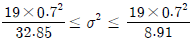
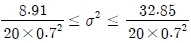
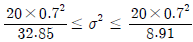
모분산의 신뢰구간은 이므로 이 된다.
자유도는 이고 분자는 이다.
주어진 조건에서 이므로 큰 분위수 32.85가 분모로 갈 때 하한, 인 8.91이 분모로 갈 때 상한이 된다.실제 값으로는 가 나온다. 분자에 표본크기 20이 아니라 자유도 19가 들어간다는 점이 판단의 갈림길이다.
오류나 개정된 내용이 보이면 알려주세요
성인의 흡연율은 40%로 알려져 있다. 금연의 중요성을 강조하는 공익 광고를 실시하면 흡연율이 감소할 것이라는 주장을 확인하기 위한 귀무가설 H0 와 대립가설 H1은?
H0:p = 0.4, H1:p ≠ 0.4
H0 p < 0.4, H1:p ≥ 0.4
H0 p >0.4, H1:p ≤ 0.4
H0 p = 0.4, H1:p < 0.4
공익광고로 흡연율이 감소할 것이라는 주장을 검정하려면, 귀무가설은 흡연율이 변화 없다는 로 두고 대립가설은 감소 방향인 로 설정한다.
연구자가 입증하고자 하는 '감소'라는 방향성이 대립가설에 담기고, 귀무가설은 기존에 알려진 값(현상 유지)을 그대로 사용하는 것이 검정 설계의 기본 원칙이다.
오류나 개정된 내용이 보이면 알려주세요
정규분포 N(12, 22)를 따르는 확률변수 x 로부터 크기 n개의 표본을 뽑았다. 표본평균이 10과 14사이에 있을 확률이 0.9975라면 몇 개의 표본을 뽑은 것인가? (단, P(|Z|<3) = 0.9975, P(Z<3) = 0.9987)
36
25
16
9
표본평균의 분포는 를 따르므로 표준오차는 이다.
표본평균이 10과 14 사이일 확률이 와 같다는 것은 을 의미한다.
이를 풀면 이므로 이다.
오류나 개정된 내용이 보이면 알려주세요
어느 중학교 1학년의 신장을 조사한 결과 평균이 136.5㎝ , 중앙값은 130.0㎝였다. 신장의 표준편차가 2.0㎝라면 이 분포에 대한 설명으로 옳은 것은?
오른쪽으로 긴 꼬리를 갖는 비대칭분포이다.
왼쪽으로 긴 꼬리를 갖는 비대칭분포이다.
정규분포이다.
이들 자료로는 알 수 없다.
평균(136.5cm)이 중앙값(130.0cm)보다 크므로, 분포는 오른쪽으로 긴 꼬리를 갖는 양(+)의 왜도를 갖는 비대칭분포이다.
일반적으로 소수의 매우 큰 값이 존재하면 평균이 중앙값보다 커지면서 오른쪽 꼬리가 길어지는 형태가 나타난다.
오류나 개정된 내용이 보이면 알려주세요
다음 분산분석표의 ( )에 알맞은 것은?
| 요인 | 제곱합 | 자유도 | 평균제곱 | F | 유의확률 |
|---|---|---|---|---|---|
| 처리 | 9.214 | 3 | 3.071 | ( B ) | 0.010 |
| 잔차 | ( A ) | 135 | 0.775 | ||
| 계 | 113.827 | 138 |
A : 104.613, B : 3.963
A : 101.321, B : 1.963
A : 103.223, B : 3.071
A : 104.231, B : 0.775
잔차 제곱합 A=104.613, 검정통계량 B=3.963이다.
총제곱합은 처리와 잔차로 분해되므로 이다.
자유도도 로 표와 맞고, 잔차 평균제곱을 되짚으면 로 표의 값과 일치해 A가 검증된다.F값은 처리 평균제곱을 잔차 평균제곱으로 나눈 값이므로 이다.
처리 평균제곱 역시 로 확인되며, 유의확률 0.010과 함께 처리 간 차이가 유의함을 보여준다.
오류나 개정된 내용이 보이면 알려주세요
분산에 관한 설명으로 틀린 것은?
편차제곱의 평균이다.
자료가 평균에 밀집할수록 분산의 값은 더욱 작아진다.
분산은 양수 또는 음수를 취한다.
자료가 모두 동일한 값이면 분산은 0이다.
분산은 편차를 제곱한 값의 평균이므로 항상 0 이상의 값만 가지며, 음수를 취할 수 없다.
오류나 개정된 내용이 보이면 알려주세요
어느 한 집단에 대해서 신체검사를 하였다. 검사 결과 중 키와 발의 산포크기를 비교하고자 할 때 가장 적합한 것은?
변동계수
분산
표준편차
결정계수
키와 발처럼 측정 단위나 평균 크기가 다른 두 변수의 산포를 비교할 때는 상대적 산포도인 변동계수(coefficient of variation)를 사용한다.
변동계수는 표준편차를 평균으로 나눈 값이라서 단위나 규모의 차이를 제거하고 상대적인 흩어진 정도를 비교할 수 있다. 분산이나 표준편차는 원래 단위에 의존하므로 규모가 다른 변수를 직접 비교하기에 적합하지 않다.
오류나 개정된 내용이 보이면 알려주세요
모분산의 추정에서 추정량으로 사용하는 표본분산은 n으로 나누지 않고 n-1 로 나눈 것을 사용 한다. 그 이유는 무엇 때문인가?
편향되지 않기 때문이다.
효율적이지 않기 때문이다.
일치하지 않기 때문이다.
충분하지 않기 때문이다.
표본분산을 n이 아닌 n-1로 나누는 이유는 n으로 나눈 추정량이 모분산을 과소추정하는 편향(bias)을 갖기 때문이며, n-1로 나누어야 불편추정량이 된다.
즉 n으로 나눈 통계량은 기댓값이 모분산보다 작게 나오는 편향된 추정량이므로, 이를 보정하기 위해 자유도를 하나 줄인 n-1을 분모로 사용한다.
오류나 개정된 내용이 보이면 알려주세요
평균이 50이고, 표준편차가 10인 어떤 자료에 값이 모두 동일하게 10인 6개의 자료를 더 추가하였다. 표준편차의 변화는?
당초의 표준편차보다 더 커진다.
당초의 표준편차보다 더 작아진다.
변하지 않는다.
판단할 수 없다.
평균 50, 표준편차 10인 자료에 평균에서 크게 벗어난 값 10을 6개 추가하면, 새로 추가된 값들이 전체 평균과 멀리 떨어져 있어 산포가 오히려 커지고 표준편차는 당초보다 더 커진다.
표준편차는 자료가 평균 주위에 밀집할수록 작아지는데, 기존 평균(50)과 크게 다른 값(10)이 섞이면 전체 자료의 흩어진 정도가 커지므로 표준편차가 증가하는 방향으로 작용한다.
오류나 개정된 내용이 보이면 알려주세요
확률변수 x는 이항분포 B(n,p)를 따른다고 하자. n=10, p=0.5일 때, 확률변수 X의 평균과 분산은?
평균 2.5, 분산 5
평균 2.5, 분산 2.5
평균 5, 분산 5
평균 5, 분산 2.5
이항분포 의 평균은 , 분산은 이다.
를 대입하면 평균은 , 분산은 이다.
오류나 개정된 내용이 보이면 알려주세요
어느 선거구의 특정 정당에 대한 지지율을 조사하고 자 한다. 지지율의 90% 추정오차한계가 5% 이내가 되기 위한 표본의 크기는 최소한 얼마 이상이어야 하는가?(단, Z~N(0,1) 일 때 P(Z≤1.645)=0.95)
371
285
385
271
모비율 추정오차한계 는 로 나타나며, 비율 정보가 없을 때는 산포가 가장 큰 를 대입해 보수적으로 표본크기를 구한다.
이므로, 오차한계를 만족하려면 표본크기는 최소 271 이상이어야 한다.
오류나 개정된 내용이 보이면 알려주세요
A 도시에 새벽 1시부터 3시 사이 일어나는 범죄 건수는 시간당 평균 0.2건이다. 범죄발생건수의 분포가 포아송분포를 따른다면, 오늘 새벽 1시와 2시 사이에 범죄발생이 전혀 없을 확률은?
약 62%
약 72%
약 82%
약 92%
포아송분포에서 1시간 동안의 평균 발생건수는 이다.
범죄가 전혀 발생하지 않을 확률은 로, 약 82%에 해당한다.
오류나 개정된 내용이 보이면 알려주세요
올해 국가자격시험 A종목의 성적 분포는 평균이 240점, 표준편차가 40점인 정규분포를 따른다고 한다. 이 자격시험에서 360점을 맞은 학생의 표준화 점수는?
-1.96
-3
1.96
3
표준화 점수는 로 계산한다.
이므로, 이 학생의 표준화 점수는 3이다.
오류나 개정된 내용이 보이면 알려주세요
작년도 자료에 의하면 어느 대학교의 도서관에서 도서를 대출한 학부 학생들의 학년별 구성비는 다음과 같다면, 이 자료를 갖고 통계적인 분석을 하는 경우 사용하게 되는 검정 통계량은?
1학년 12%, 2학년 20%, 3학년 33%, 4학년 35%였다. 올해 이 도서관에서 도서를 대출한 학부 학생들의 학년별 구성비가 작년도와 차이가 있는가를 분석하기 위하여 학부생 도서 대출자 400명을 랜덤하게 추출하여 학생들의 학년별 도수를 조사하였다.
자유도가 4인 카이제곱 검정통계량
자유도가 (3, 396)인 F-검정통계량
자유도가 (1, 398)인 F-검정통계량
자유도가 3인 카이제곱 검정통계량
미리 정해진 비율과 관측도수가 맞는지 보는 적합도 검정이므로 자유도 3인 카이제곱 검정통계량을 사용한다.
비교 대상은 1학년 12%, 2학년 20%, 3학년 33%, 4학년 35%라는 작년 구성비에서 얻은 기대도수와 올해 400명에서 관측된 학년별 도수이며, 로 계산한다.
자유도는 범주 수에서 1을 뺀 이다. 평균 비교가 아니라 도수의 비율 비교이므로 F 검정통계량을 쓰는 상황이 아니고, 범주가 4개라고 해서 자유도를 4로 두어서도 안 된다.
오류나 개정된 내용이 보이면 알려주세요
n개의 자료 x1,x2,x3,....,xn의 분산이 10일 때, 각 자료에 5를 더한 자료들의 분산은?
10
20
40
50
모든 자료에 동일한 상수 5를 더해도 자료들 사이의 상대적인 흩어진 정도(편차)는 변하지 않으므로 분산은 그대로 10이다.
상수를 더하는 것은 분포 전체를 평행이동시킬 뿐 자료 간 간격을 바꾸지 않기 때문에, 평균은 5만큼 커지지만 분산은 영향을 받지 않는다.
오류나 개정된 내용이 보이면 알려주세요
일원배치법의 모집단 모형 Yij=μ+αi+εij 에서 오차항 εij의 가정에 대한 설명으로 틀린 것은?
오차항 εij 는 정규분포를 따른다.
모든 오차항 εij는 서로 독립이다.
오차항 εij의 기댓값은 0이다.
오차항 εij의 분산은 동일하지 않아도 된다.
일원배치법에서 오차항 은 정규분포를 따르고, 서로 독립이며, 기댓값이 0이라는 가정 외에 모든 처리집단에서 분산이 동일하다는 등분산성 가정도 반드시 필요하다.
따라서 '오차항의 분산은 동일하지 않아도 된다'는 설명은 등분산 가정을 위배하는 잘못된 진술이다.
오류나 개정된 내용이 보이면 알려주세요
A대학교 전체의 남녀 비율은 남자가 60%이고, 남학생이면서 머리를 염색한 학생의 비율은 30%이다. 남학생 1명을 뽑았을 때 그 학생이 머리를 염색하였을 확률은?
0.1
0.2
0.3
0.7
구하는 값은 '남학생을 뽑았다'는 조건 아래 그 학생이 머리를 염색했을 확률, 즉 조건부확률이다.
제시된 30%는 남학생 집단 안에서 머리를 염색한 학생이 차지하는 비율이므로, 남학생 1명을 뽑았을 때 그 학생이 머리를 염색했을 확률은 0.3이 된다.
남자가 60%라는 정보는 전체 학생 중에서 남학생을 뽑을 확률에 해당하는 값으로, 이미 남학생을 뽑은 상황을 전제한 이 문제에서는 확률 계산에 직접 쓰이지 않는다.
오류나 개정된 내용이 보이면 알려주세요
일원배치 모형을 xij=μ+αi+εij (i=1,2,...k; j=1,2,...n)로 나타낼 때, 분산분석표를 이용하여 검정하려는 귀무가설 H0는?(단, i는 처리, j는 반복을 나태는 첨자이며, 오차항 εij~N(0,σ2)이고 서로 독립적이며 )
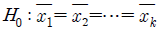
H0 : α1 = α2 = ..... = αk = 0
H0 : 적어도 한 αij 는 0이 아니다.
H0 오차항 εijαi들은 서로 독립이다.
일원배치 분산분석의 귀무가설은 모든 처리효과가 0이다, 즉 이다.
모형 에서 는 i번째 처리의 효과이므로, 이것이 모두 0이라는 진술은 k개 처리의 모평균이 모두 같다()는 말과 같다.
오류나 개정된 내용이 보이면 알려주세요
회귀분석에서 관측값과 예측값의 차이는?
오차(error)
편차(deviation)
잔차(residual)
거리(distance)
회귀분석에서 관측값과 예측값(회귀식으로 추정한 값)의 차이를 잔차(residual)라고 부른다.
오차(error)는 모집단의 참값과 관측값의 차이를 가리키는 이론적 개념인 반면, 잔차는 표본에서 추정된 회귀식을 기준으로 실제 계산할 수 있는 값이라는 점에서 구분된다.
오류나 개정된 내용이 보이면 알려주세요
통계적 가설의 기각여부를 판정하는 가설검정에 대한 설명으로 옳은 것은?
표본으로부터 확실한 근거에 의하여 입증하고자 하는 가설을 귀무가설이라 한다.
유의수준은 제 2종 오류를 범할 확률의 최대허용 한계 이다.
대립가설을 채택하게 하는 검정통계량의 영역을 채택역이라 한다.
대립가설이 옳은데도 귀무가설을 채택함으로써 범하게 되는 오류를 제 2종 오류라 한다.
대립가설이 참인데도 귀무가설을 채택함으로써 범하는 오류를 제2종 오류라고 정의하는 설명이 옳다.
오류나 개정된 내용이 보이면 알려주세요
다음 중 의미가 다른 것은?

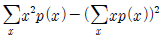
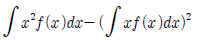
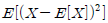
분산은 이므로, 로 쓴 식만 분산이 아니어서 의미가 다르다.
나머지 세 식은 같은 분산을 표현만 달리한 것이다.
제곱항의 위치가 뒤바뀐 식은 값이 음수가 될 수도 있어 분산이 될 수 없다는 점으로 걸러진다.
오류나 개정된 내용이 보이면 알려주세요
대학생이 졸업 후 취업했을 때 초임수준을 조사하였다. 인문사회계열 졸업자 10명과 공학계열 졸업자 20명을 각각 조사한 결과 평균초임은 210만원과 250만원이었으며 분산은 각각 300만원과 370만원이었다. 두 집단의 평균차이를 추정하기 위한 합동분산 (pooled variance)은?
325.0
324.3
346.7
347.5
합동분산은 두 집단의 분산을 자유도로 가중평균한 값으로, 로 계산한다.
인문사회계열()과 공학계열()을 대입하면
계산 결과 합동분산은 347.5이다.
오류나 개정된 내용이 보이면 알려주세요
회귀식에서 결정계수 R2에 관한 설명으로 틀린 것은?
단순회귀모형에서는 종속변수와 독립변수의 상관계수의 제곱과 같다.
R2은 독립변수의 수가 늘어날수록 증가하는 경향이 있다.
모든 측정값이 한 직선상에 놓이면 R2의 값은 0 이다.
R2 값은 0에서 1까지 값을 가진다.
모든 측정값이 하나의 회귀직선 위에 정확히 놓이면 예측이 완벽하게 들어맞는 것이므로 결정계수는 0이 아니라 이 된다.
오류나 개정된 내용이 보이면 알려주세요
[사회조사분석사 2급 필기] 13년 1회차 시험지 PDF 다운로드·인쇄 →
[사회조사분석사 2급 필기] 13년 1회차 정답과 해설은 무료인가요?
이 페이지의 100문항 정답과 해설은 로그인 없이 무료로 볼 수 있습니다. 무제한 풀이·실전 모의고사·PDF 출력·전자책 다운로드는 베이직 플랜에 포함됩니다.
이 회차를 CBT 로 직접 풀어볼 수 있나요?
사회조사분석사 2급 필기 기출문제 암기장에서 이 회차를 회차별·랜덤으로 풀고 오답노트에 자동으로 모을 수 있습니다. 사회조사분석사 2급 필기 기출문제 풀러 가기 →
시험지 PDF 나 전자책으로도 볼 수 있나요?
이 회차의 인쇄용 시험지 PDF 페이지에서 시험지를 받을 수 있습니다. 시험지 PDF 받기 →